Déposez n'importe quelle vidéo
Collez un lien ou téléversez un fichier. Une vidéo YouTube, un enregistrement Zoom ou Teams, un webinaire, un MP4. Lirovo la récupère et s'occupe des parties pénibles pour vous.
Voir les sources prises en chargeOpen source · votre propre inférence
Un agent gratuit et open source qui transforme n'importe quelle vidéo en données structurées et liées aux preuves, directement depuis votre terminal.
La plupart des outils vous remettent une transcription et appellent ça des données. Lirovo vous donne les faits : les affirmations, décisions et chiffres contenus dans la vidéo, structurés, notés, traçables jusqu'à la seconde exacte d'où ils proviennent, et confrontés à leurs sources.
Collez un lien ou téléversez un fichier. Une vidéo YouTube, un enregistrement Zoom ou Teams, un webinaire, un MP4. Lirovo la récupère et s'occupe des parties pénibles pour vous.
Voir les sources prises en chargeLirovo transcrit l'audio et lit en même temps ce qui est à l'écran : diapositives, graphiques, sous-titres, texte à l'écran. La moitié qui est dite et la moitié qui est montrée, toutes deux capturées.
Voir comment fonctionne la captureLes mots prononcés et les moments à l'écran sont alignés seconde par seconde, puis connectés dans un graphe vivant des personnes, sujets, chiffres, affirmations et décisions présents dans la vidéo.
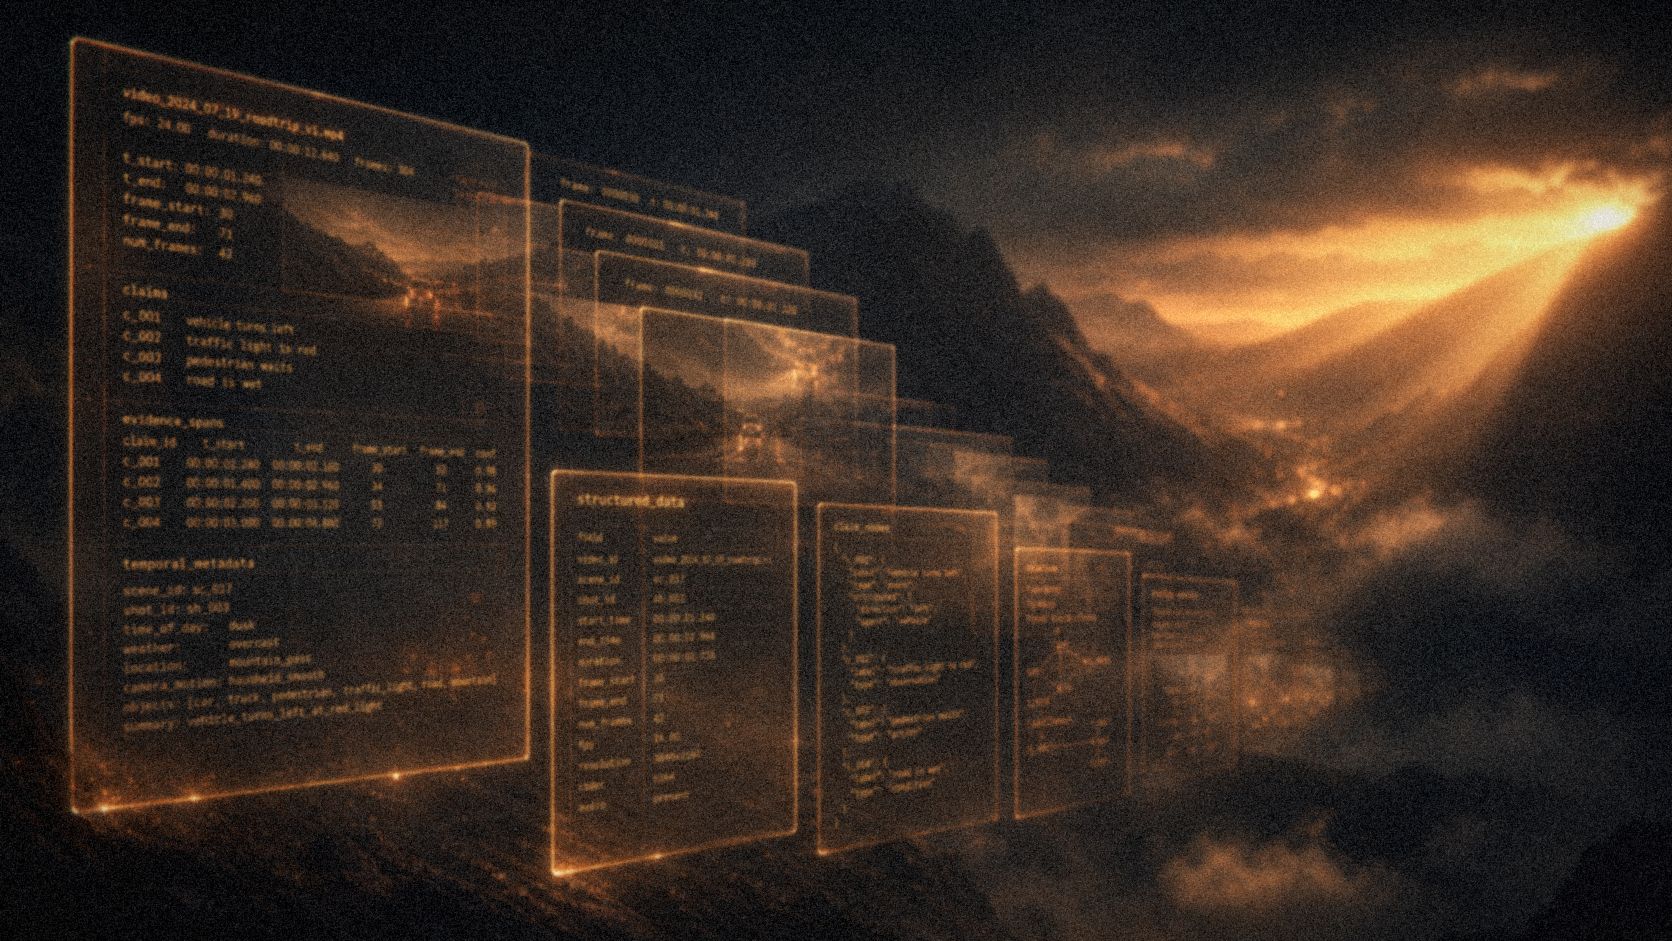
Voir le grapheIndiquez à Lirovo les champs souhaités : noms, affirmations, décisions, chiffres, sujets. Il renvoie du JSON typé avec un score de confiance sur chaque valeur, prêt pour un tableur, une base de données ou votre application.
Voir un exempleChaque valeur renvoie à la seconde exacte d'où elle provient, et indique si elle a été dite à voix haute ou montrée à l'écran. Lirovo signale les désaccords entre les deux et confronte les affirmations à leurs sources, pour que vous puissiez vérifier chaque résultat vous-même.
Comment fonctionnent les preuvesLirovo tourne comme sa propre application de terminal, ou comme plugin dans le harnais d'agent que vous utilisez déjà. Donnez-lui un lien, recevez du JSON typé avec une citation pour chaque valeur, le tout sur votre propre inférence.
extract() donnez-lui une vidéo et un schémaget_job() récupérez du JSON typéget_graph() parcourez le graphe de connaissancesget_evidence() citez le moment exactdeliver() envoyez-le là où vous travaillezLa plupart des vidéos sont traitées de bout en bout en minutes, pas en heures. Le gros du travail média, détection de scènes et déduplication des images, s'exécute avant tout appel de modèle, donc votre inférence ne sert que là où ça compte.
En savoir plusChaque valeur extraite renvoie à la seconde exacte d'où elle provient, avec sa modalité enregistrée. Les affirmations sont confrontées à leurs sources, donc rien n'est une boîte noire.
En savoir plusTranscription, lecture de l'écran et raisonnement s'exécutent comme un seul pipeline local, sur l'inférence que vous utilisez déjà. Rien à configurer, et votre vidéo ne quitte jamais votre machine.
En savoir plusD'autres questions ? Nous sommes ravis de vous aider à cadrer votre cas d'usage.
Parlez-nous